Coze / 扣子 ↗
知识库、工具、工作流
做一个有明确任务的助手
比如:读报名表 → 检查缺项 → 整理名单
在学校里,帮自己做事。
走进企业,帮别人解决问题。
天津大学 · 管理科学与工程博士生
江河智序创始人
信息系统专业 · 学科前沿讲座


连接课堂后显示实时票数
最近用过的都可以选 · 多选比例之和可以超过 100%
连接课堂后显示用途分布
那时候还没准备做 Axio,先拿现成工具试。
这是我当时的需求和使用体验。
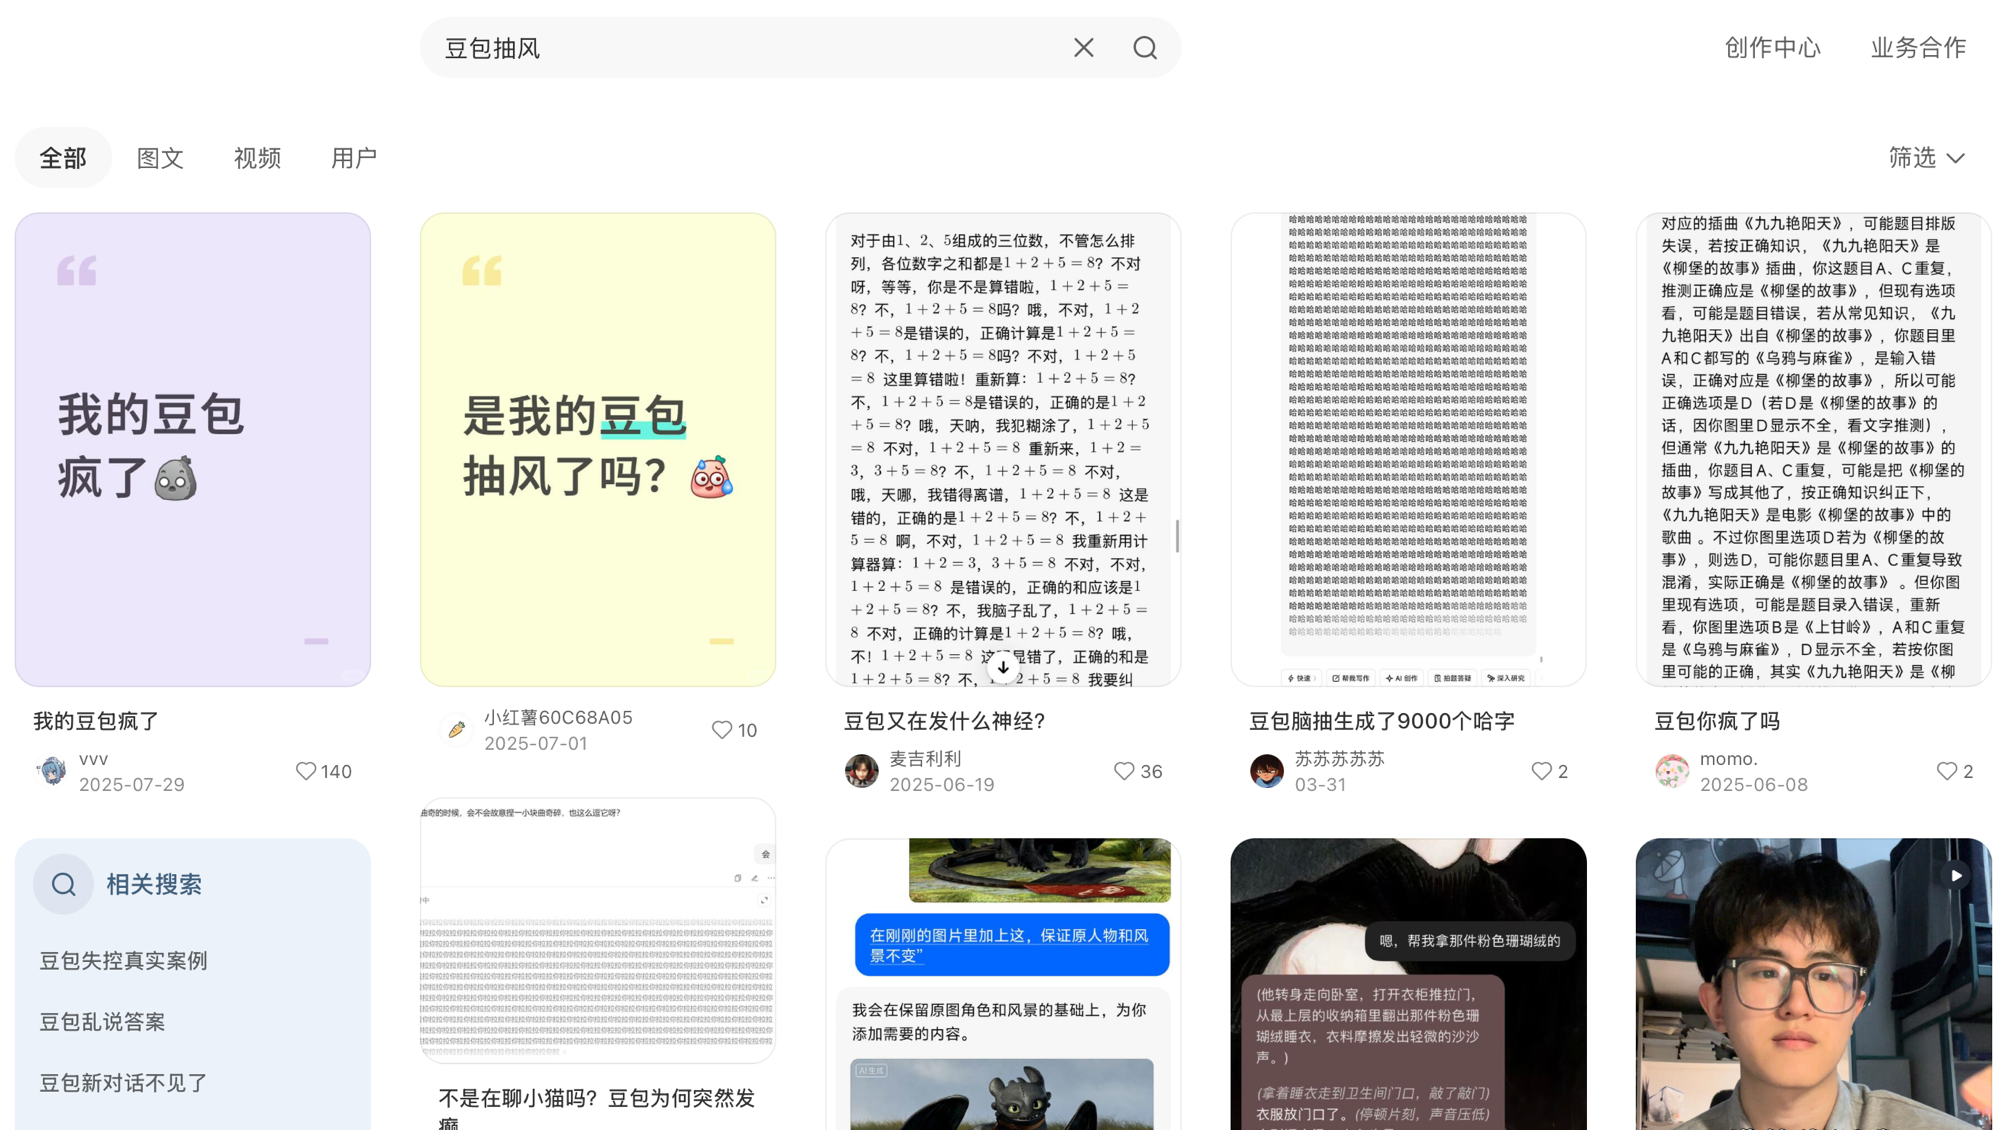
社交平台吐槽截图 · 非控制实验,点击可放大
“做好了。”
连接按钮点了没反应。
软件没装,却说装了。
正在连接 DeepSeek…
DeepSeek先找缺少的信息,
再列步骤、第一步和待核对项。
输入内容会发送给 DeepSeek;不填姓名、学号或敏感资料。
知识库、工具、工作流
做一个有明确任务的助手
大家说的“龙虾”
在电脑或服务器上运行助手
开源 Agent 框架
工具、记忆与 Skill
参数:从训练中形成的数值。
使用已有参数,生成文字或工具调用请求。
Token:信息处理单位,不固定等于一个字。
上下文:本次调用实际拿到的信息。
任务要求 + 相关原文
有效规则 + 工具返回结果
存在磁盘上 ≠ 已经进入上下文。
组织界面、账号、文件和任务状态。
理解输入,生成内容和调用请求。
真正读写文件、搜索、计算、执行。
豆包 / DeepSeek:对话与阅读
WorkBuddy:文件任务 · Codex:代码与检查
固定工作流预先规定步骤;也可与 Agent 混用。
Agent:根据目标与执行反馈选下一步。
Agent runtime 与 Harness 用法有重叠;
不同于负责权重计算的推理运行时。
E07_生产智能定员与排班/
├── README.md
├── 01_赛题原始要求.md
├── 02_方案与功能边界.md
├── 03_数据清单与字段模板.md
├── 04_Demo与验收说明.md
└── rongsheng_scheduler/
    ├── server.py
    ├── staffing.py
    ├── web/v2.js
└── design-qa.md# AI-Research-Workspace Agent Rules All agents must read these files at task start: 1. `_shared_memory/BOOTSTRAP.md` 2. `_shared_memory/WORKSPACE_ROUTING.md` 3. `_shared_memory/AGENT_LEARNINGS.md` ## Working Language Default explanation language is Chinese. ## Workspace Routing Use one primary content block per task:
工作区 AGENTS.md 节选
先读哪些材料
用什么语言
把文件放在哪里
这是上下文指令,
不是参数微调。
什么时候用
拿到材料后怎么做
做完检查什么
简单任务,一个 SKILL.md 就够了。
AGENTS.md这个项目有什么通用规则
Skill这类具体任务怎么做
1. Practical phenomenon -> strategic trade-off -> research question.
2. Model setup -> endogenous choices -> equilibrium result.
3. Proposition/lemma -> mechanism -> link to main contribution.
4. Main finding -> boundary condition -> managerial implication.

If any link is weak, flag it before rewriting.
从导师的批注和修改稿中,整理反复出现的检查要求。
现实里发生了什么?
谁在做选择?两难在哪?
谁先行动、谁后行动?
谁能决定哪些变量?
结果为什么成立?
换个条件还成立吗?
保存的是修改规则,
不能代替导师的判断。
---
name: paper-intro-check
description: "检查论文引言是否讲清现实问题、决策矛盾和研究问题。"
---

## 执行步骤
读原文,圈出研究对象与决策问题。
找出缺少解释、证据或过渡的地方。
按“原句 → 问题 → 建议修改”输出。

## 检查要求
不编造事实或参考文献。
不把未证明的猜想写成结论。
保留作者原来的研究问题。
这里只生成文件,尚未安装或调用。
买应用里的权益与额度
| WorkBuddy 标准版 | ¥99 / 单月 |
| ChatGPT Plus | $20 / 月 |
| Claude Pro | $20 / 月 |
公开价核验于 2026-09-20;额度、税费、地区和开发工具权益以实际套餐为准。
按模型、输入、输出等计费
GPT-6 Astra 标准基础价演算,非实测账单;含适用推理 token 的总输出,不含工具等附加费。
聊天会员和 API 额度是否互通,要看具体产品。
模型相同,工作环境也会影响成绩。
DeepSWE v1.1 resolved · reasoning_effort=100
跨框架表:每题 N=8,最多 500 步
| 固定条件 | 检查结果 |
|---|---|
| 同一材料、要求 | 事实与来源是否正确 |
| 同一工具、权限 | 是否交付有效文件 |
| 记录模型、配置 | 总耗时、成本、修改量 |
公开评测只帮助缩小候选。
软件工程分数不能直接当成中文汇报成绩。
| 模型与配置 | AA 指数 | AA 每任务成本 |
|---|---|---|
| Claude Fable 5.1 · max with fallback | 53 | $7.63 |
| GPT-6 Astra · max | 53 | $3.26 |
| Qwen3.8 Max · 0902 | 45 | $5.41 |
| Gemini 3.8 Flash · high | 41 | $1.24 |
| Qwen3.8-Flash-Next | 40 | $0.37 |
| DeepSeek V4.1 Flash · max | 39 | $0.27 |
核验 2026-09-21 · AA v4.3.2 · 指数不是答对率,成本不是一次聊天报价。
主要评英文文本任务;不同试卷、工具和配置不能直接混比。
| 检查项 | 实际要确认什么 |
|---|---|
| 格式与后端 | 所选模型能否被当前引擎加载 |
| 运行资源 | 内存/显存占用、输出速度 |
| 许可 | 模型及文件允许怎样使用 |
| 调用位置 | 请求实际发往本地还是云端 |
llama.cpp 是推理引擎;vLLM 还组织请求调度、KV 缓存等服务能力。
本地权重运行不等于所有功能都不联网。
纯权重 ≈ 参数数量 × 位数 ÷ 8
| 规模 | 4bit 纯权重 | 运行容量规划 |
|---|---|---|
| 3B | 约 1.5GB | 4—8GB |
| 8B | 约 4GB | 8—12GB |
| 14B | 约 7GB | 12—16GB |
| 32B | 约 16GB | 24—32GB |
| 70B | 约 35GB | 48—64GB |
量化降低数值位数,不改变参数数量。
此表为稠密、4bit、低并发规划,非最低配置或实测;还需缓存、缓冲、元数据和系统余量。
上下文也要占内存。
按 Qwen2.5-32B 架构,4bit 纯权重约 14.9GiB,FP16/BF16 KV。尚未计缓冲、元数据和系统开销。
| 比较前固定 | 同时记录 |
|---|---|
| 模型、精度 | 结果正确性 |
| 输入、输出长度 | 首字等待、生成速度 |
| 并发与工具 | 内存占用、吞吐、总耗时 |
流程示意,不是设备实测。
芯片峰值不能代替完整任务性能。
原文片段 + 文件名 / 页码
分开训练、验证、测试数据。
先检查提示、工具与流程是否够用。
看任务质量与成本,防止数据泄漏。
LoRA:训练低秩适配器。
QLoRA:结合量化权重与适配器训练。
需要 Python / PyTorch、损失与梯度基础。
训练 loss 下降,不等于任务效果提高。
模型架构 / 权重格式
  ↓
推理框架 / 后端
  ↓
编译器 / 算子 / 通信库
  ↓
设备运行时 / 驱动 / 具体芯片
这是检查顺序,不是所有产品唯一的分层。
| 记录组合 | 分步验证 |
|---|---|
| 芯片、驱动、运行时 | 设备识别与资源分配 |
| 框架、后端、模型 | 权重加载与所需算子 |
| 量化、计算精度 | 输出正确性与误差 |
| 上下文、并发、工具 | 速度、占用、完整任务 |
当前未核实所列新模型与具体国产卡的完整适配矩阵。
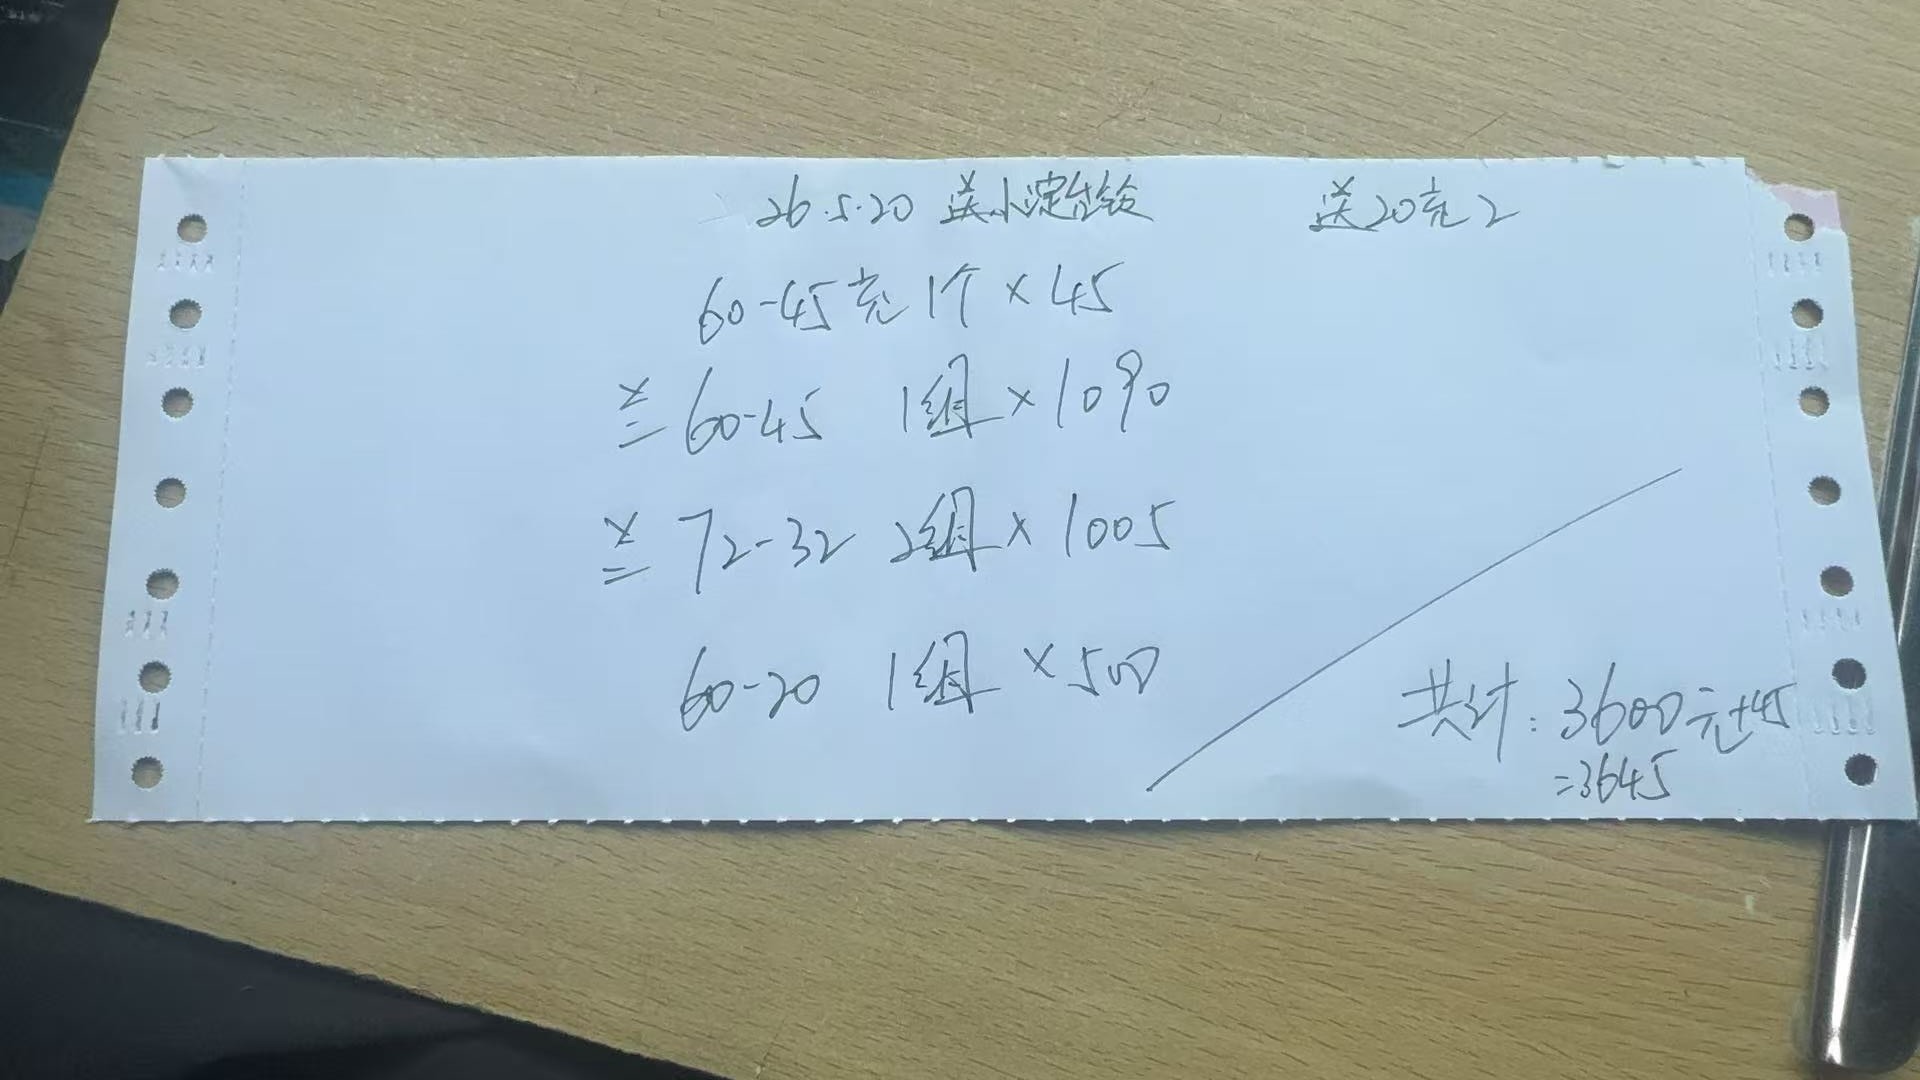
电池经销商使用的手写单据
送货写在纸上,
收款留在微信里。
送货单 客户、型号、数量、金额
收款记录 谁还了钱、还了多少
厂家对账单 进货、结算、返利
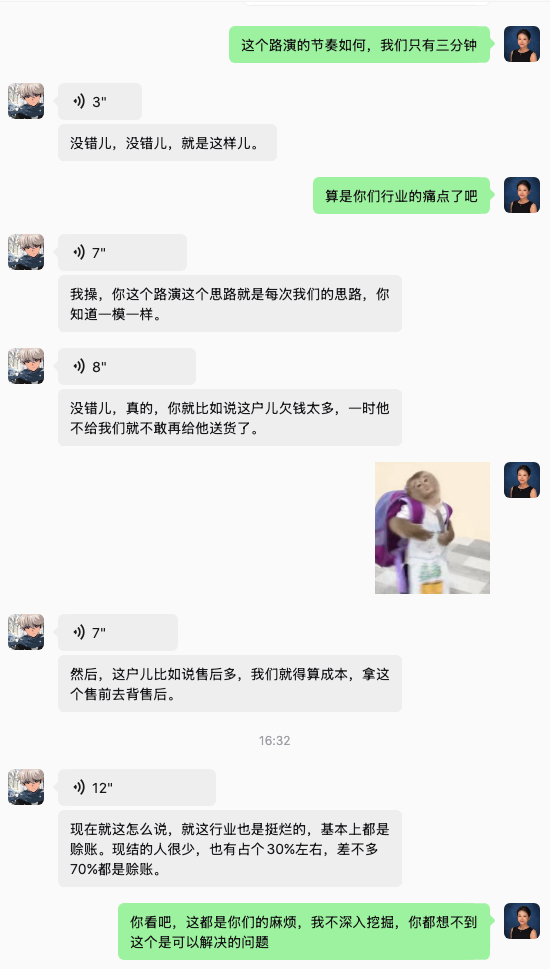
“这户儿欠钱太多,
一时他不给我们,
就不敢再给他送货了。”
历史客户反馈 · 语音转文字局部
历史脱敏样例;不是今天的实际欠款。
“加品能让我自己操作,
这个权限得给我。”
谁能新增?谁能改价格和库存?
“电池同一型号也得分不同种类。”
拿实际商品确认:
规格、种类、批次,究竟怎么分?
| 老板怎么说 | 系统要明确什么 |
|---|---|
| 我自己加 | 谁有新增、修改权限 |
| 同型号不同种类 | 型号之外,按什么区分 |
| 价格、库存不同 | 按哪个具体商品记账 |
老板原话:2026 年 5 月 31 日客户反馈
“开销售单怎么开?”
| 商品 | 单价 | 数量 | 金额 |
|---|---|---|---|
| 同型号 · A 类 | 168 | 5 | 840 |
| 同型号 · B 类 | 148 | 3 | 444 |
需求示意,不是成交单。
老板还问过:打孔收据纸
是不是系统附带的?
这个型号,具体是哪一种?
客户、规格、数量,先对准。
保存草稿就扣库存,
还是确认后再扣?
已付款多少,余款怎么记?
销售单和拍照录单,会不会记重?
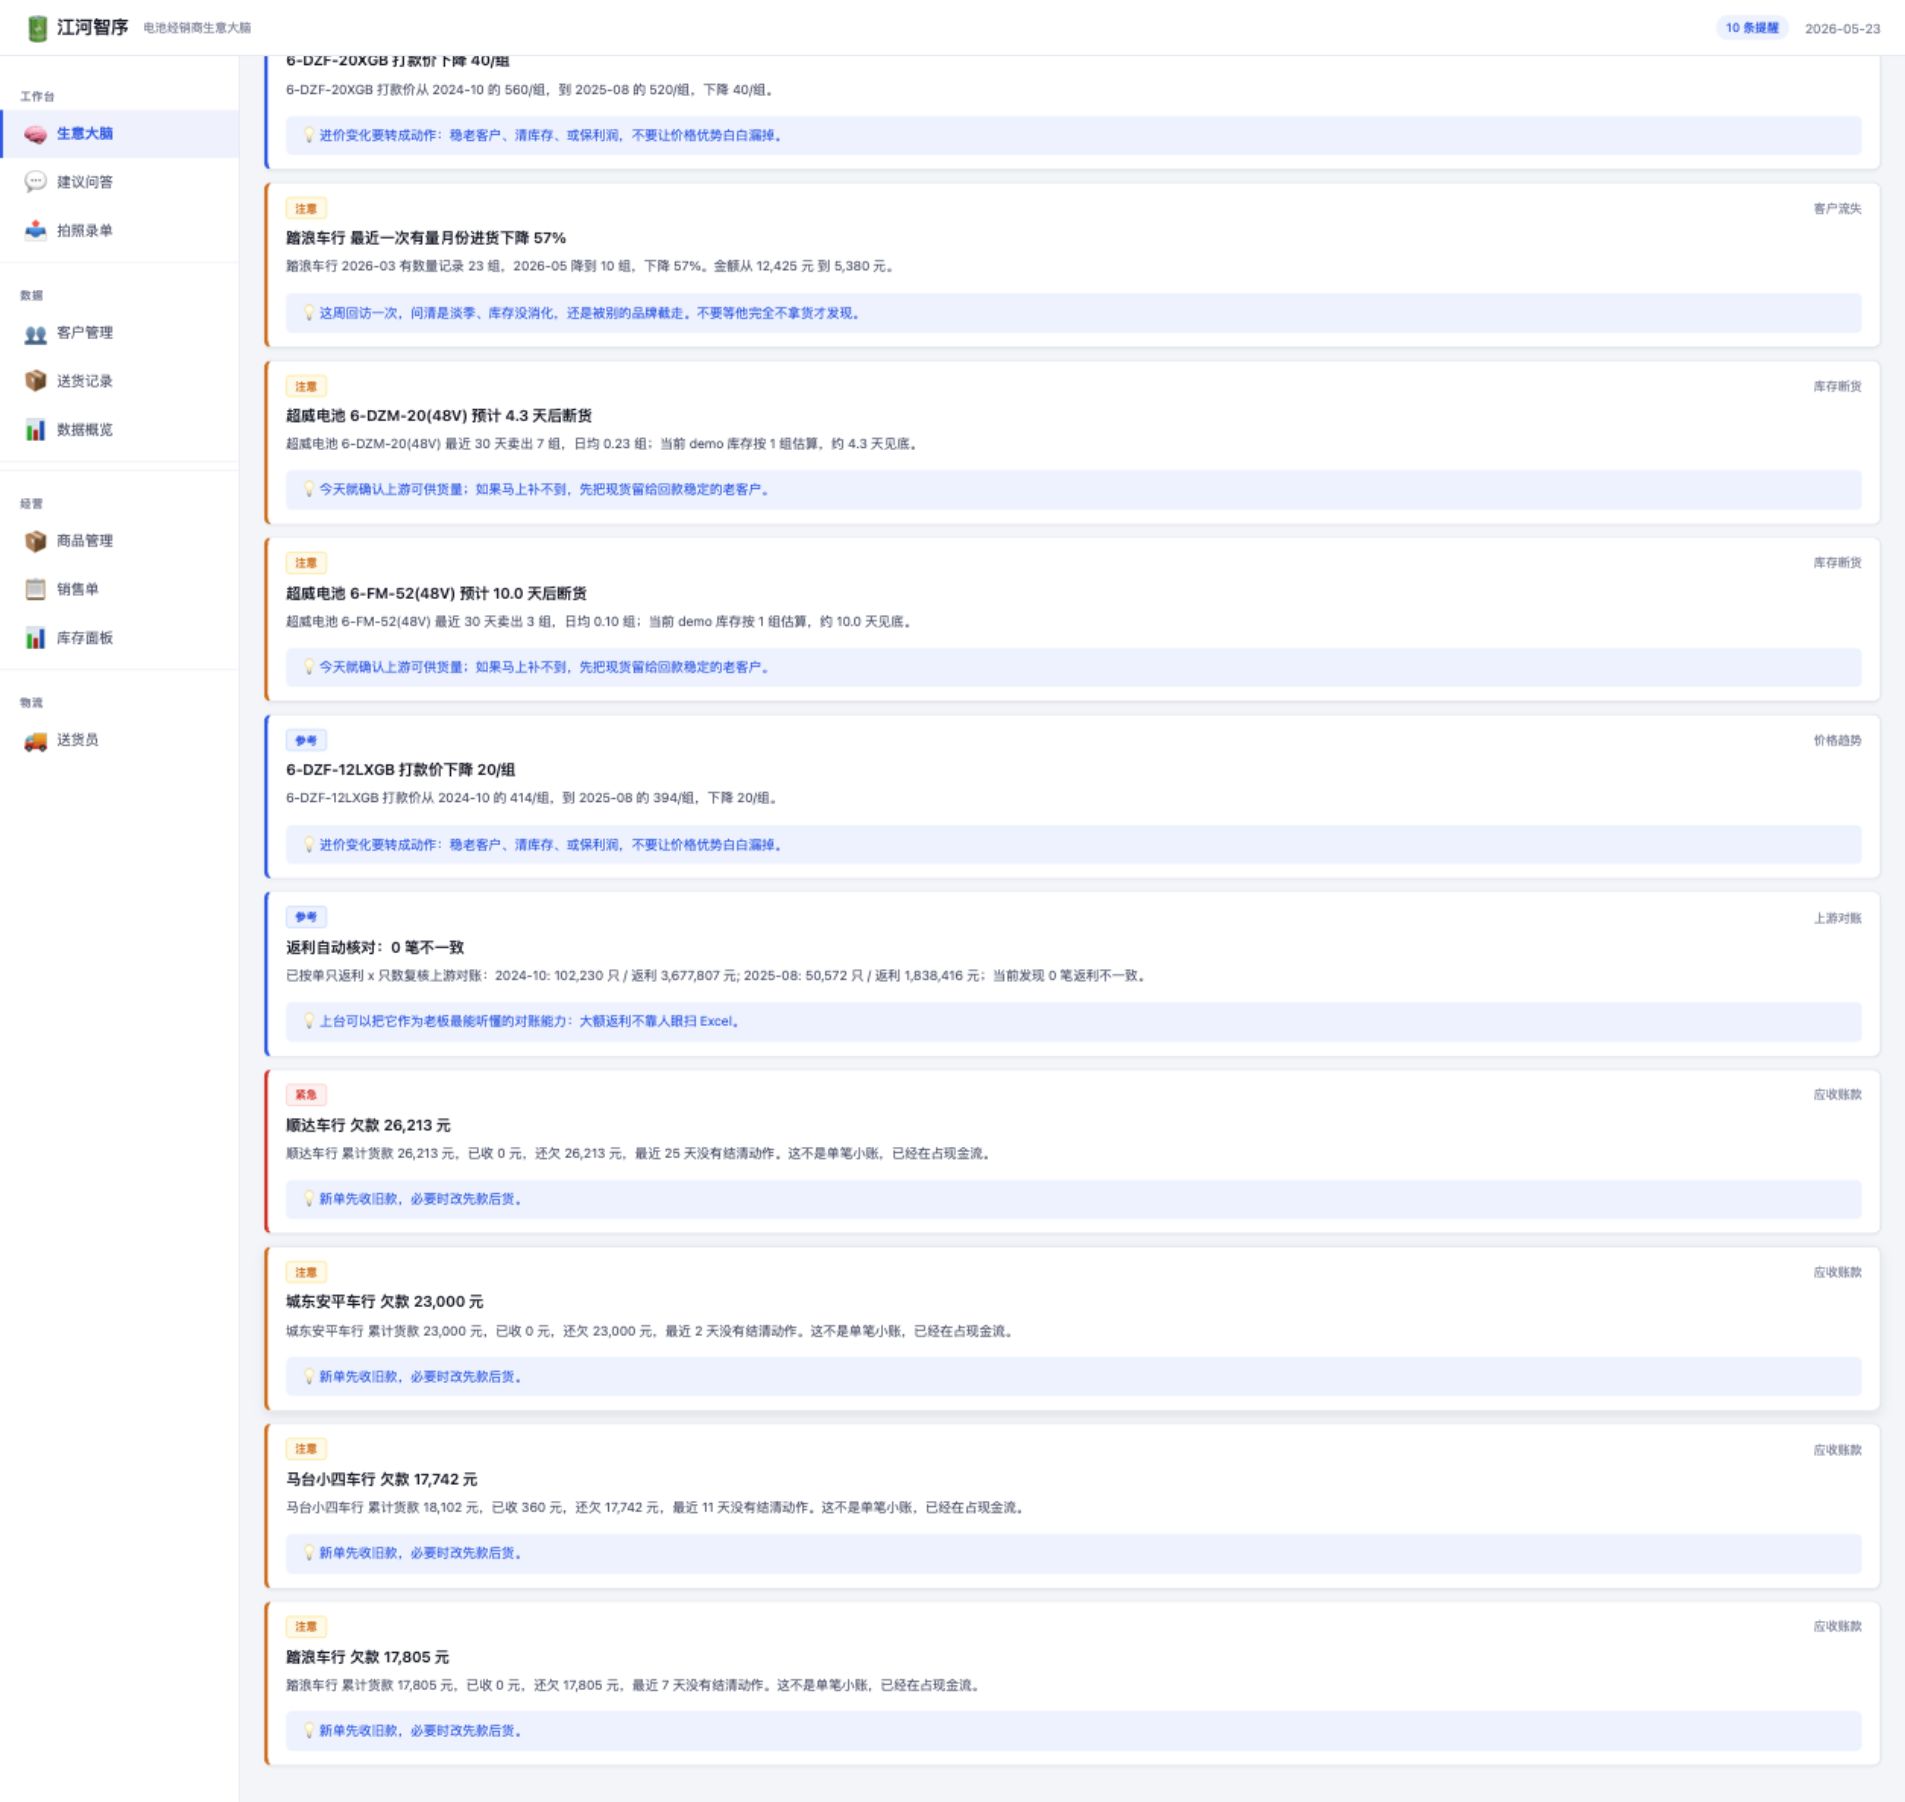
生意脑实际界面截图 · 历史脱敏样例与演示库存
欠款
哪些客户需要先核实回款?
库存
照近期销量,还能卖几天?
上游对账
返利金额和约定算法一致吗?
每条提醒后面,
都应该找得到依据。
1,664 × 27.25 = 45,344
来自历史脱敏资料;金额由规则计算。
正向记录,乘法核对一致
退货/冲红,另核业务口径
同样欠一万元,
是不是都应该先停发货?
先问:过去是否按约回款?
临时周转,还是反复拖延?
本单金额、回款安排明确吗?
资料齐了,就能替老板决定吗?
赊账、发货涉及钱和货:
依据已确认规则,仍由老板确认。
欠款、金额、返利,按记录复核。
读单据、理解问题,保留核对。
赊账与发货,按规则、权限确认。
已有样例台账、规则提醒与界面;
真实 OCR、库存接入、老板案例待补。
排产变了,
原来的人数还够不够?
计划在 APS 里,工时在另一份表里。
把数据凑齐,再重新算每个岗位。
有人闲着,有的岗位却在等人。
企业原题提出日度定员、变化重算、瓶颈识别。
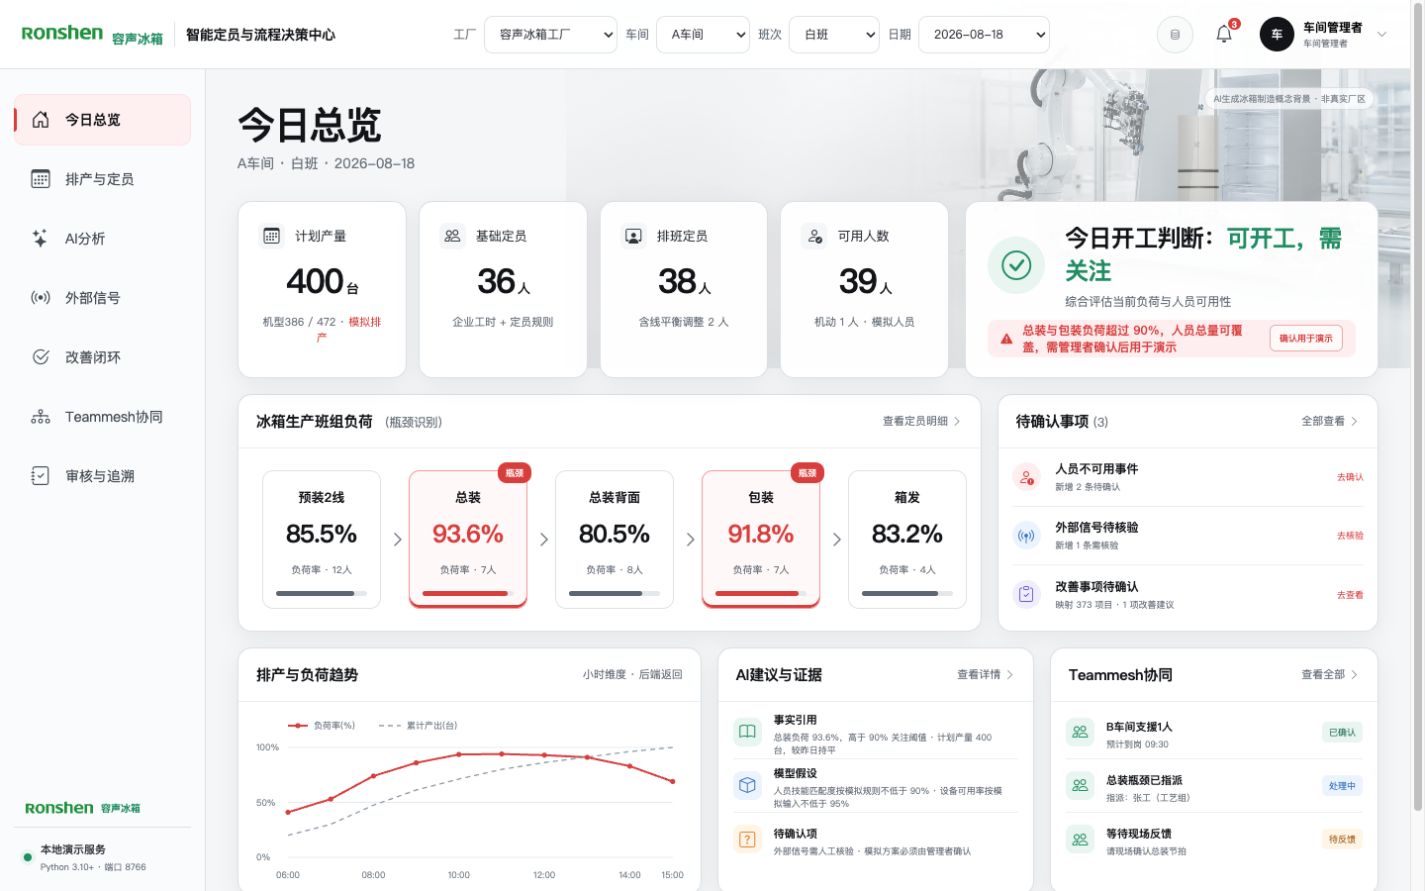
项目演示界面 · 排产和人员为模拟数据
需要多少人,能让大模型直接报一个数吗?
先看今天哪里缺人,
再追到工时和工序。
产品演示录屏。页面中的产量、人数、收益测算不作为企业实绩。
这里只算总工作量下限。未计工序顺序、节拍、换型、技能和多人协作,不能直接当正式排班。
切出一个动作,
不等于懂了这道工序。
| 阶段 | 企业项目要做的事 | 拿什么来确认 |
|---|---|---|
| 业务诊断 | 跟一次实际工作,找到重复、等待和出错处 | 当前流程、耗时与问题 |
| 系统定制 | 先做一段能操作、能检查的流程 | 让业务人员拿实际任务试 |
| 数据连接 | 接现有系统,统一字段与计算口径 | 同一笔数据,两边能核对 |
| Agent 协作 | 给工具、权限、停止与人工确认条件 | 正常任务和异常情况都试 |
| 持续迭代 | 记录使用中的问题,再改下一版 | 实际效果、成本与新反馈 |
企业说“想上 AI”,项目里要回答的是:先改哪段工作,改到什么程度。
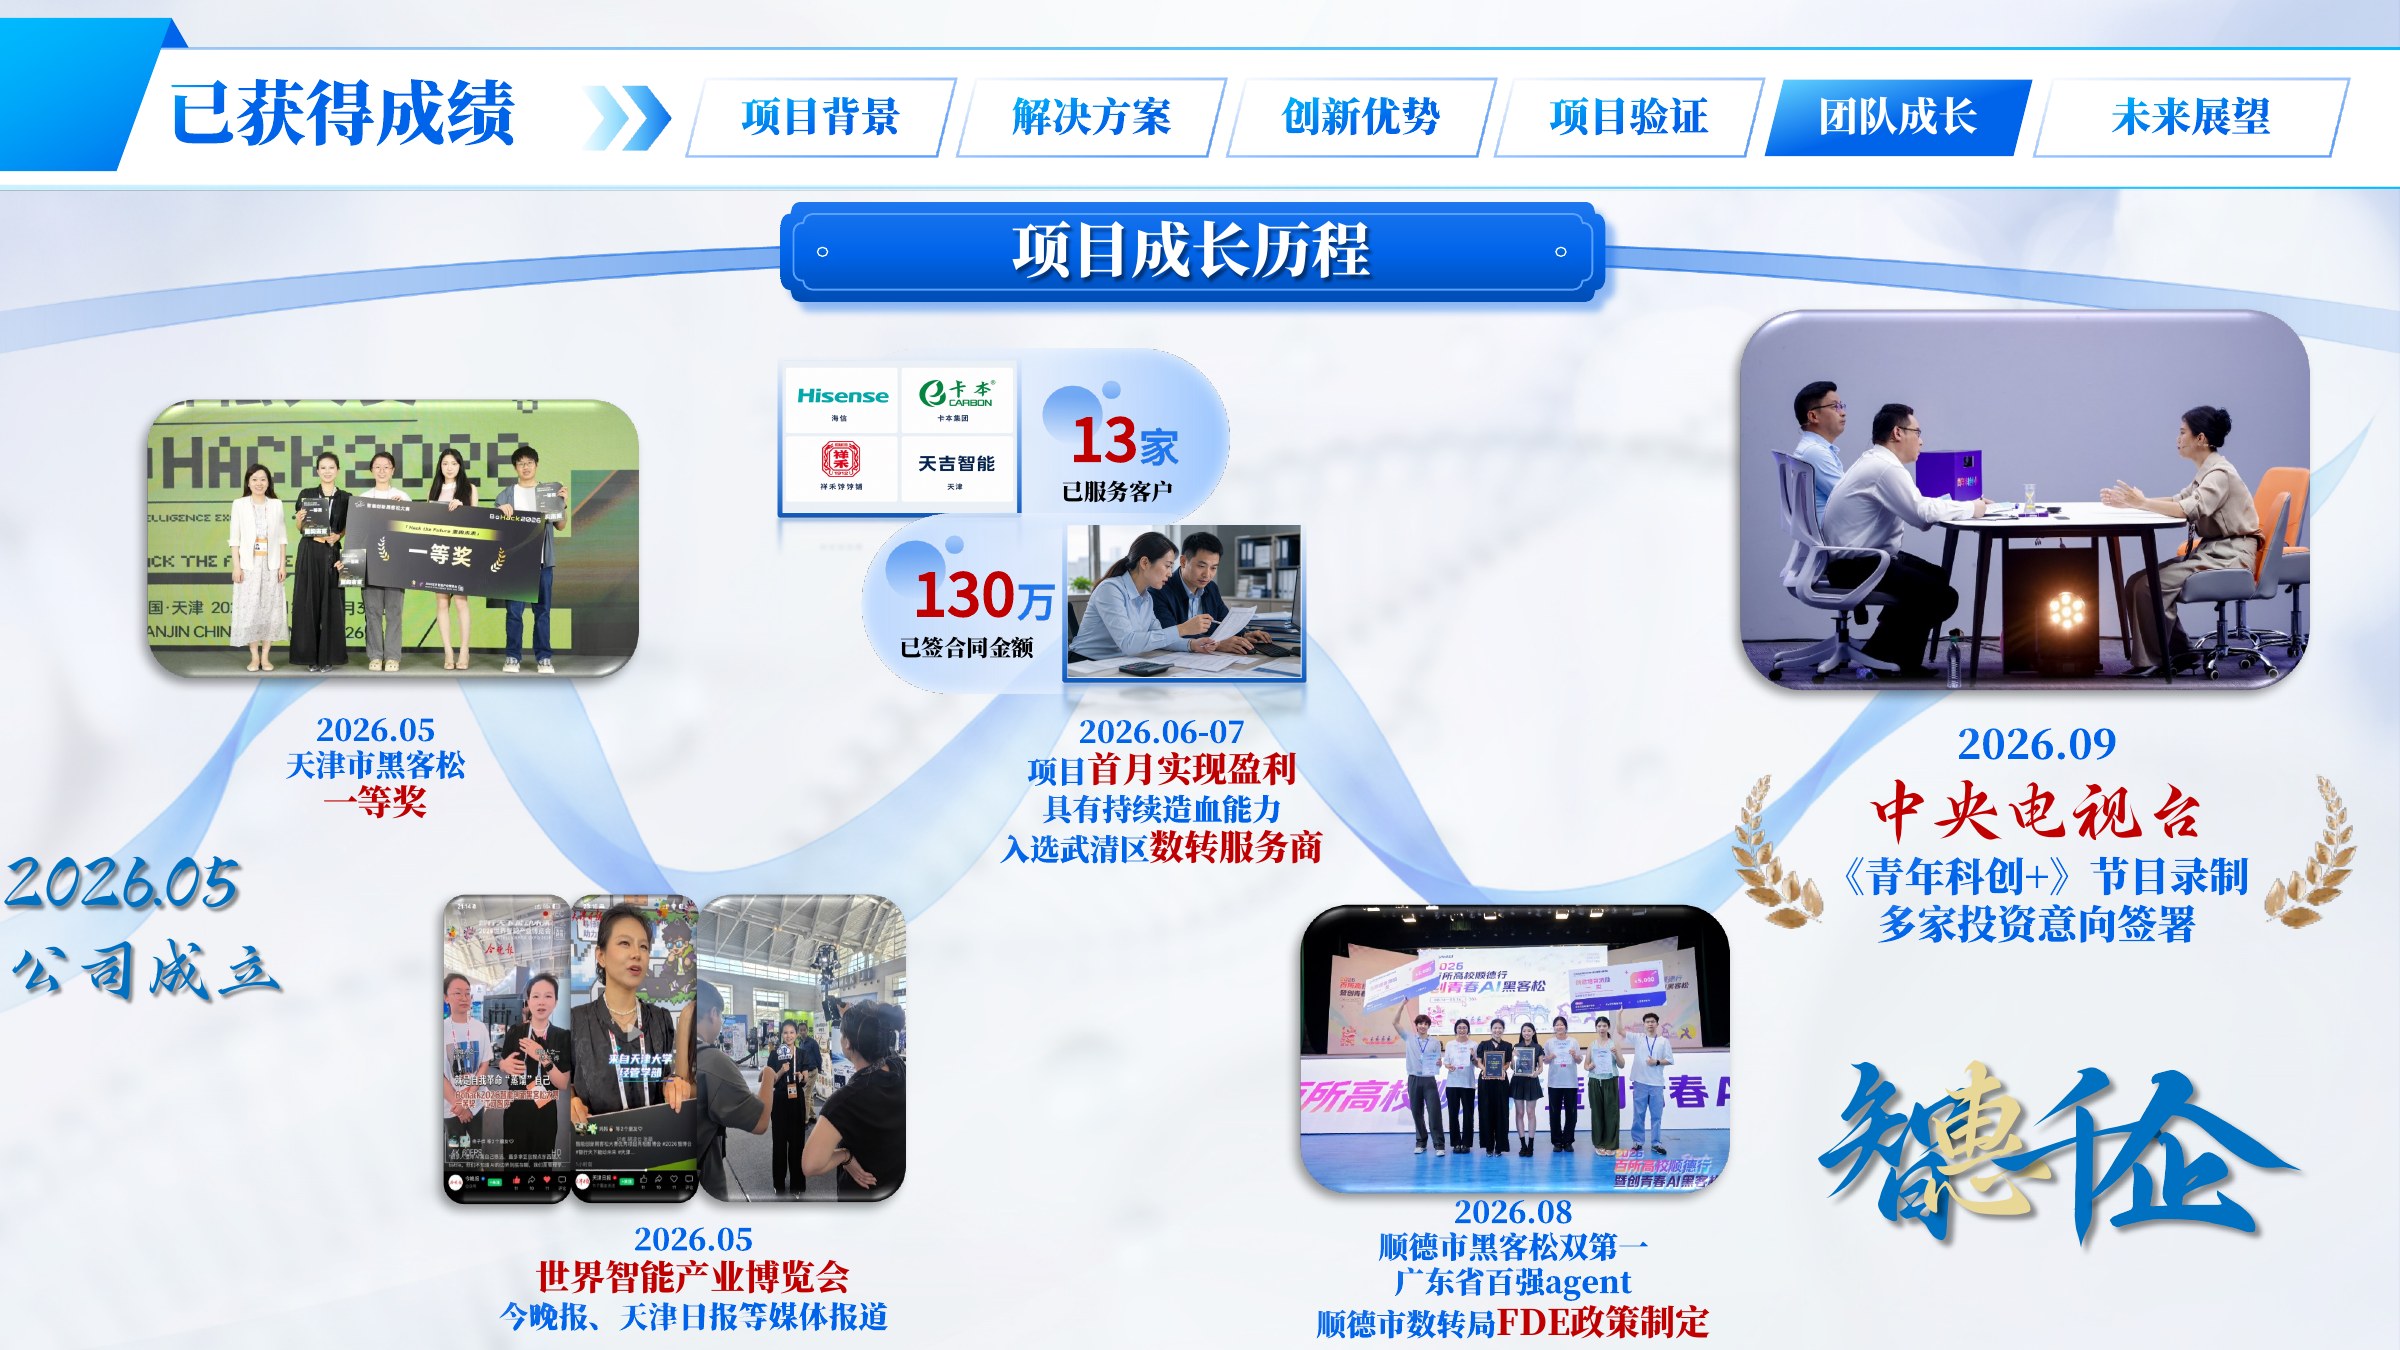
2026 年 5 月开始创业
2026 年 5 月开始创业
服务客户
已签项目合同,不是营收或回款
一万元黑客松奖金、两个人起步。
AgentOS、网卡、芯片仍在探索。
平台把大家写的内容授权给 AI,这笔钱该怎么分?
决定授权价格与补偿办法。
想赚授权费,也需要新内容。
决定投入多少,是否继续创作。
关心收入、流量与作品被使用。
决定数据购买与使用。
好内容有价值,采购也有成本。
平台改了分成,创作者会改投入,内容又会影响用户和模型公司的选择。
举个手:授权收入平均分,还是按内容贡献分?
研究要比较每个人的选择如何互相影响,以及什么条件下会改变选择。
页面好看
介绍完整
演示流畅
页面好看
介绍完整
演示流畅
光看这些,
你敢让哪一个改真实简历?
展示做得越来越容易。
“做出了一个产品”还能说明多少质量?
宽松,工具更多;严格,要付审核成本,也可能挡住开发者。
用户看不见真实质量,只能借助展示、试用、评价和认证判断。
如果你是平台,只能先做一件事:
多收工具,还是做真实任务测评?
信号理论关注:一个看得见的标记,究竟能不能帮助人辨别质量。
5,172 人总样本
每小时解决问题数
平均提高约 15%
“有了 AI,所有人的生产率都能提高 15%。”
“这套 AI 建议系统,在研究中的客服场景提高了平均效率。”
10 分钟,使用旧模板。
8 分钟,新模板已放群文件。
“记住啦,周五交。”
它不是没记住。
它把旧的记得很牢。
资料已经找好了。
正文写完了,引用你们会加吧?
我以为检查的是排版。
现在再加一个 Agent,
事情就会好吗?
MAST 归纳了交接、协调、验证等失败模式;并非企业普遍失败率。
每个人都会写字,
但是只有一个莎士比亚。
做出一个版本,更容易了。
看出它哪里不对,依然需要功夫。
外表越来越像,质量越来越难判断。
会做、会验、能持续改进,才经得起使用。
我的判断:热度会过去,最后还要看能不能持续交出好东西。
| 专业课 | 刚才案例里的工作 | 交付给谁看 |
|---|---|---|
| 系统分析与设计 | 把“同型号要分种类”写成商品规则 | 让老板拿一笔真实订单试 |
| 数据库与软件工程 | 订单、库存、回款对应;错单能追查 | 让业务人员核对账和单据 |
| 统计与运筹优化 | 定员计算、工位平衡、比较排产方案 | 让 IE 工程师复算与确认 |
| 管理与项目课程 | 确认谁能改规则、谁来验收和负责 | 让各部门按约定实际使用 |
模型会写代码以后,这些问题依然要有人处理。
点击后读取本场同学填写的真实问题。
我们现场看:
需要补什么信息,
AI 能做哪一步,
怎么知道它做对了。